EDITORIAL VOL. 11 2026 – Evolución tecnológica al servicio de la comunicación científica. MOJP 4.0 y una nueva etapa de desarrollo editorial
EDITORIAL VOL. 11 2026 – Technological Evolution in the Service of Scientific Communication: MOJP 4.0 and a New Stage in Editorial Development (Read the full text in English)
Rocío Silveira de Andrade revista@fundacionmenteclara.org.ar
Universidad Argentina de la Empresa, Argentina
ORCID: http://orcid.org/0000-0002-9140-3299
Cómo citar este artículo / Citation: Silveira de Andrade R. (2026). EDITORIAL VOL. 11 2026 – Evolución tecnológica al servicio de la comunicación científica. MOJP 4.0 y una nueva etapa de desarrollo editorial. Revista Científica Arbitrada de la Fundación MenteClara, Vol. 11 (470). DOI: https://doi.org/10.32351/rca.v11.470
Copyright: © 2026 RCAFMC. Este artículo de acceso abierto es distribuido bajo los términos de la licencia Creative Commons Attribution 4.0 International License (CC BY 4.0). Publicación online: 10/11/2026.
Resumen
Este editorial presenta MOJP 4.0, una evolución tecnológica de la infraestructura editorial de la Revista Científica Arbitrada de la Fundación MenteClara, desarrollada por Oscar R. Gómez y su equipo de ingenieros sobre OJS 3.5.0.5. Se describen sus principales innovaciones: la optimización de la arquitectura de metadatos, la incorporación de esquemas semánticos interoperables, la mejora de la identificación de autores e instituciones mediante identificadores persistentes, la ampliación de los servicios OAI-PMH y la integración de metadatos XMP en documentos PDF. Asimismo, se presenta Custom Head Injector, un módulo nativo de MOJP 4.0 y compatible con OJS 3.5.0.5 o superior, que amplía las posibilidades de personalización e integración de metadatos, esquemas semánticos y servicios externos en la cabecera HTML de las plataformas editoriales. El editorial también introduce Módulo XMP-PDF, una tecnología destinada a enriquecer los documentos científicos con información estructurada sobre su identidad bibliográfica, procedencia editorial, derechos y otros datos relevantes. Estos desarrollos se inscriben en una trayectoria institucional de innovación, autonomía tecnológica y compromiso con los principios de apertura, interoperabilidad y circulación de la información científica.
Abstract
This editorial presents MOJP 4.0, a technological evolution of the editorial infrastructure of the Peer-Reviewed Scientific Journal of the MenteClara Foundation, developed by Oscar R. Gómez and his engineering team on the basis of OJS 3.5.0.5. It describes its main innovations: optimization of the metadata architecture, implementation of interoperable semantic schemas, improved identification of authors and institutions through persistent identifiers, expansion of OAI-PMH services, and integration of XMP metadata into PDF documents. It also presents Custom Head Injector, a native MOJP 4.0 module compatible with OJS 3.5.0.5 and later versions, which expands the possibilities for customizing and integrating metadata, semantic schemas, and external services into the HTML header of editorial platforms. The editorial also introduces the XMP-PDF Module, a technology designed to enrich scientific documents with structured information about their bibliographic identity, editorial provenance, rights, and other relevant data. These developments are part of an institutional trajectory of innovation, technological autonomy, and commitment to the principles of openness, interoperability, and the circulation of scientific information.
Palabras Claves: Acceso abierto diamante; Política editorial; Sostenibilidad editorial; MOJP 4.0; comunicación científica; infraestructura editorial; metadatos académicos; interoperabilidad; identificadores persistentes; OAI-PMH; XMP; Custom Head Injector; OJS
Keywords: Diamond Open Access; Metadata; Editorial policy; Editorial sustainability; MOJP 4.0; scientific communication; editorial infrastructure; scholarly metadata; interoperability; persistent identifiers; OAI-PMH; XMP; Custom Head Injector; OJS
Estimados lectores:
Cerramos el año con una nueva etapa de innovación tecnológica para nuestra revista. Nuestro equipo de ingenieros ha desarrollado e incorporado mejoras de última generación que fortalecen la infraestructura editorial, amplían las posibilidades de interoperabilidad y contribuyen a una circulación más eficiente de la producción científica. Compartimos con ustedes estos avances, fruto de nuestro compromiso sostenido con la calidad, la innovación y el desarrollo independiente de tecnología para la comunicación científica.
La comunicación científica no depende exclusivamente de la calidad de los contenidos que publica. También requiere una infraestructura tecnológica capaz de garantizar que la información se encuentre disponible, pueda ser identificada y procesada correctamente, y conserve su integridad a lo largo del tiempo. La plataforma editorial, los sistemas de intercambio de metadatos y los propios documentos científicos forman parte de esa infraestructura y condicionan las posibilidades de circulación del conocimiento.
Desde sus comienzos, la Revista Científica Arbitrada de la Fundación MenteClara ha considerado que la independencia editorial debe estar acompañada por una capacidad equivalente de desarrollo tecnológico. Nuestra experiencia con Open Journal Systems (OJS), plataforma de código abierto desarrollada por el Public Knowledge Project (PKP), nos permitió construir y sostener un modelo de publicación científica de acceso abierto diamante, sin cargos para autores ni lectores. Sin embargo, la experiencia acumulada también puso de manifiesto que las necesidades de una publicación científica no siempre encuentran respuesta suficiente en las configuraciones estándar de las plataformas disponibles.
La evolución de nuestra infraestructura fue, por lo tanto, un proceso continuo de investigación, adaptación y desarrollo. No se limitó a incorporar nuevas versiones de software: implicó revisar componentes, modificar procesos, desarrollar soluciones propias y ampliar las posibilidades de gestión y circulación de la información científica.
Este año presentamos públicamente MOJP 4.0 (MenteClara Open Journal Platform), desarrollada por Oscar R. Gómez junto con su equipo de ingenieros, a partir de OJS 3.5.0.5. Esta puesta en producción representa un hito técnico e institucional para la Fundación MenteClara y consolida una línea de trabajo orientada a la soberanía de la información, el rendimiento, la interoperabilidad y la ciencia abierta.
MOJP 4.0: una infraestructura editorial desarrollada para la ciencia abierta
MOJP 4.0 no constituye simplemente una actualización de OJS. Es una evolución integral de su arquitectura, con desarrollos propios destinados a superar limitaciones operativas y ampliar las capacidades de una plataforma editorial científica. Su concepción parte de una premisa: una infraestructura de publicación académica debe estar diseñada para facilitar tanto el trabajo editorial como la identificación, recuperación, lectura e intercambio de los contenidos que produce.
Uno de los desarrollos centrales fue la reescritura del motor de metadatos, con especial atención a la eficiencia y a la limpieza del código fuente. El resultado es una arquitectura que permite presentar la información bibliográfica y editorial de cada artículo de manera directa, estructurada y accesible. El código fuente de las páginas deja de ser un aspecto secundario de la presentación web para convertirse en una parte esencial de la infraestructura de comunicación científica.
Esta decisión se vincula con el concepto de Zero-JS Dependency, es decir, la disponibilidad de la información fundamental sin necesidad de ejecutar JavaScript. Los sistemas de recuperación e indización, como Dialnet, OpenAlex, SciELO, Redalyc, REDIB, DOAJ y Google Scholar, entre otros servicios de descubrimiento e información científica, pueden acceder a los datos esenciales del artículo sin tener que procesar grandes cantidades de código, resolver dependencias externas ni atravesar mecanismos de cookies para obtener la información bibliográfica.
En MOJP 4.0, los datos fundamentales —autores, identificadores ORCID, DOI, afiliaciones y enlaces a los archivos PDF y HTML— se encuentran disponibles directamente en los primeros kilobytes del código fuente. Esta disposición reduce las intermediaciones técnicas y facilita que los sistemas automatizados puedan reconocer la estructura de cada publicación desde el primer acceso.
Coexistencia de esquemas semánticos y metadatos estructurados
La disponibilidad directa de los metadatos se complementa con la incorporación simultánea de distintos esquemas internacionales de descripción. MOJP 4.0 permite que la información de cada artículo se presente mediante estructuras semánticas compatibles con diferentes sistemas de procesamiento y recuperación.
Entre ellas se encuentran:
- Highwire Press / Google Scholar tags: con elementos como citation_author y citation_author_orcid, destinados a exponer información bibliográfica y de autoría.
- Dublin Core: con una descripción amplia que incluye elementos como DC.Creator y DC.Identifier.DOI.
- Schema.org: mediante estructuras JSON-LD de tipo ScholarlyArticle, que permiten describir el artículo utilizando un vocabulario semántico ampliamente reconocido en la web.
- Open Graph y Twitter Cards: destinados a mejorar la interpretación y presentación de los contenidos cuando se comparten en redes sociales y otros espacios digitales.
La coexistencia de estos esquemas permite que una misma publicación pueda ser interpretada desde distintas perspectivas técnicas sin depender de un único modelo de descripción. No se trata de multiplicar etiquetas sin propósito, sino de ofrecer información estructurada y coherente a los diferentes entornos que participan en la circulación del conocimiento científico.
Extensibilidad de la arquitectura: Custom Head Injector
Como parte de esta estrategia de desarrollo, incorporamos Custom Head Injector, un módulo nativo de MOJP 4.0 y reutilizable en otras instalaciones compatibles, que amplía las posibilidades de personalización de la cabecera HTML de la plataforma.
Entre sus principales características se encuentran:
- Inyección de metadatos HTML personalizados: permite incorporar información adicional a la cabecera de las páginas de la plataforma.
- Compatibilidad con esquemas semánticos: admite estructuras JSON-LD, Schema.org y Open Graph.
- Personalización visual e institucional: permite incorporar hojas de estilo CSS, favicons y enlaces institucionales.
- Integración de servicios externos: facilita la inserción de scripts de verificación y herramientas de analítica.
- Administración centralizada: todas estas configuraciones se gestionan desde el panel administrativo, sin necesidad de editar manualmente cada página.
- Software libre y compatibilidad: publicado bajo licencia GNU General Public License v3 (GPLv3), es compatible con OJS 3.5.0.5 y versiones posteriores.
Este desarrollo amplía la capacidad de adaptación de la plataforma y proporciona a otras instalaciones compatibles una herramienta reutilizable para gestionar sus propios requerimientos de integración, identificación y presentación de metadatos.
Consultar el código fuente y descargar Custom Head Injector en GitHub.
A esta arquitectura se suma la vinculación de las publicaciones con identificadores institucionales persistentes. La relación con el dominio de la Fundación MenteClara, el registro ROR 03pssnk88 y el Crossref Funder ID 100032896 contribuye a identificar de manera más precisa la procedencia institucional y las relaciones de financiación asociadas a la actividad editorial.
Rendimiento, privacidad y ausencia de dependencias comerciales innecesarias
Otro aspecto central del desarrollo es la reducción de componentes externos que no aportan valor directo a la comunicación científica. MOJP 4.0 prescinde de rastreadores comerciales, scripts publicitarios y elementos de terceros que pueden incrementar el peso de las páginas, interferir en su procesamiento o comprometer la privacidad de los lectores.
Esta decisión responde tanto a criterios de rendimiento como a una concepción institucional de la publicación científica. Una revista académica no necesita convertir la navegación de sus lectores en una fuente de explotación comercial de datos ni incorporar dependencias que dificulten el acceso a sus contenidos.
La arquitectura busca, por el contrario, que la información se presente de forma limpia, directa y eficiente. La ausencia de intermediaciones innecesarias contribuye a reducir los tiempos de carga y facilita la lectura tanto por parte de las personas como de los sistemas automatizados.
La independencia tecnológica también implica poder decidir qué componentes se incorporan, cómo se procesan los datos y qué información se expone. En ese sentido, el desarrollo propio permite adaptar la plataforma a las necesidades de la publicación sin quedar limitado por las decisiones de diseño de una configuración estándar.
Un esquema OAI-PMH ampliado: más información para la interoperabilidad
La interoperabilidad constituye otro de los ejes fundamentales de MOJP 4.0. El protocolo OAI-PMH permite que repositorios, bibliotecas digitales, agregadores y otros servicios recolecten información de las publicaciones académicas. Sin embargo, la utilidad de esa comunicación depende en buena medida de la profundidad y calidad de los metadatos que cada institución pone a disposición.
Por esa razón, desarrollamos un esquema OAI personalizado que amplía la información expuesta en las respuestas de la plataforma. Además de los elementos bibliográficos habituales, incorpora referencias completas del artículo, datos de catalogación bibliotecológica, imágenes de portada, disciplinas, agencias de financiación y otros metadatos disponibles en el registro editorial.
La intención es aprovechar al máximo la información que una revista produce y conserva durante su actividad editorial, evitando que el intercambio entre sistemas se reduzca a una identificación mínima cuando existen datos adicionales que pueden enriquecer la descripción y recuperación de los documentos.
Esta ampliación puede comprobarse directamente mediante el servicio OAI-PMH de nuestra revista. El siguiente registro permite examinar un ejemplo concreto de la información expuesta por MOJP 4.0:
Consultar un registro OAI-PMH de la Revista de la Fundación MenteClara.
La ampliación del esquema no constituye únicamente una mejora interna. Representa una forma de contribuir a que la información científica pueda circular entre diferentes infraestructuras con mayor riqueza descriptiva y mejores posibilidades de reutilización.
Identidad persistente y saneamiento histórico de registros ORCID
La trazabilidad de la autoría es otro componente esencial de la infraestructura científica. Los identificadores ORCID permiten distinguir a los investigadores y vincular sus contribuciones a lo largo del tiempo. No obstante, los cambios en los mecanismos de autenticación y en las versiones de las plataformas pueden producir inconsistencias en registros históricos.
En MOJP 4.0 se desarrolló un procedimiento para revisar y sanear de manera retroactiva los registros ORCID de más de una década de publicaciones. Esto permitió recuperar el marcado de autenticación de perfiles antiguos que, por las limitaciones de los mecanismos de autorización disponibles en versiones anteriores, habían quedado identificados como no verificados.
El trabajo permitió mantener la identificación visual de autenticación de esos registros históricos y preservar la continuidad de la información de autoría en el conjunto de la revista. No se trata solamente de incorporar ORCID a los nuevos artículos, sino de atender también la consistencia de los datos acumulados durante años de actividad editorial.
Esta tarea forma parte de una concepción de la trazabilidad que no debería limitarse a los contenidos recientes: el archivo histórico de una publicación también debe conservar una identidad institucional y bibliográfica coherente.
Inyección de metadatos XMP en las galeradas PDF
La arquitectura de metadatos de MOJP 4.0 no se limita a las páginas web ni a los registros que la plataforma ofrece mediante sus servicios de intercambio. También alcanza a los documentos PDF que constituyen una de las formas principales de circulación de los artículos científicos.
Al cerrar una galerada, cada archivo PDF recibe una incorporación de metadatos estructurados mediante XMP. Entre los esquemas y conjuntos de información utilizados se encuentran Dublin Core, PRISM, CrossMark y PDFX.
De este modo, el documento incorpora información que permite reconocer su identidad bibliográfica y editorial incluso cuando circula fuera de la página web de la revista. El PDF deja de depender exclusivamente del contexto de la plataforma desde la cual fue descargado y puede conservar información estructurada sobre el artículo y su procedencia.
Esta característica puede verificarse descargando un PDF de nuestra revista y examinando sus metadatos mediante herramientas como Exif.tools. La inspección permite observar la información incorporada directamente en el archivo y comprobar que el enriquecimiento documental no se limita a los datos visibles en la página de publicación.
La incorporación de XMP forma parte de una línea de trabajo que la Fundación MenteClara sostiene desde hace años y que, con MOJP 4.0, alcanza una nueva etapa de integración con la infraestructura editorial.
Una plataforma pensada también para quienes gestionan las revistas
El desarrollo tecnológico no tendría sentido si sus mejoras quedaran restringidas a especialistas en programación o administración de servidores. Una plataforma editorial debe permitir que los equipos responsables de las publicaciones puedan gestionar sus procesos sin tener que enfrentarse permanentemente a configuraciones complejas o a barreras técnicas que desvíen su atención de la tarea académica.
Con MOJP 4.0 se trabajó también sobre las rigideces y dificultades operativas encontradas en las versiones estándar de OJS. El objetivo fue construir un entorno de gestión más amigable, que permita completar los procesos editoriales de principio a fin sin exigir conocimientos técnicos previos ni cursos complejos para utilizar sus funciones habituales.
Esta orientación es especialmente importante para las revistas independientes, las instituciones académicas pequeñas y medianas y los proyectos editoriales que sostienen modelos de acceso abierto diamante. La falta de recursos técnicos no debería convertirse en una desventaja estructural que impida ofrecer publicaciones con una infraestructura de calidad.
MOJP 4.0 busca demostrar que el desarrollo tecnológico propio puede reducir esa brecha. La combinación de una base de código abierto con adaptaciones específicas permite construir soluciones avanzadas sin trasladar los costos de las grandes infraestructuras comerciales a los autores ni a los lectores.
¿Página web o motor de visibilidad científica?
Una publicación científica no debería ser evaluada exclusivamente por la apariencia de su página web. El diseño visual es importante para la lectura y la experiencia de navegación, pero la circulación académica depende también de cómo los motores de búsqueda, los servicios de indización y los sistemas de intercambio reconocen e interpretan la información de cada artículo.
Por eso, una parte sustancial del trabajo realizado en MOJP 4.0 se concentró en la estructura técnica que permanece detrás de la página visible. La calidad de los metadatos, su ubicación, la coherencia entre esquemas y la disponibilidad de los datos para sistemas automatizados son aspectos que pueden influir en la forma en que una publicación es procesada por el ecosistema científico digital.
En nuestras pruebas y análisis comparativos, la arquitectura de metadatos de MOJP 4.0 alcanza un nivel de desarrollo que puede contrastarse con el de grandes plataformas editoriales internacionales, como Springer Nature y The Lancet. La comparación no se limita a la cantidad de etiquetas, sino que considera la disponibilidad de los datos, la coexistencia de esquemas, la identificación institucional y la información incorporada a los documentos.
El análisis técnico realizado frente a The Lancet permite destacar varios aspectos:
Análisis comparativo técnico: MOJP 4.0 y The Lancet (Elsevier)
|
Aspecto evaluado |
The Lancet (Elsevier) |
MOJP 4.0 |
|
Carga e indización (Zero-JS) |
Arquitectura basada en frameworks JavaScript, cookies y scripts externos. La extracción automatizada de información puede requerir la ejecución de código y el procesamiento de dependencias. |
Arquitectura Zero-JS Dependency. Los metadatos esenciales están disponibles directamente en los primeros kilobytes del código fuente, sin necesidad de ejecutar JavaScript ni resolver cookies. |
|
Integración de identificadores (ORCID, ROR y Funder ID) |
Integración de ORCID en los registros de autores activos. La cobertura y validación de registros históricos pueden variar. |
Integración de ORCID, ROR y Crossref Funder ID, con saneamiento retroactivo de registros históricos de autoría y conservación de la identificación visual de ORCID autenticados. |
|
Coexistencia de esquemas semánticos |
Utilización de Highwire Press, Dublin Core y Schema.org. |
Coexistencia de Highwire Press, Dublin Core completo, Schema.org mediante JSON-LD y Open Graph / Twitter Cards. |
|
Metadatos XMP en galeradas PDF |
Incorporación de metadatos en los archivos PDF variable según la publicación y el período de producción; numerosos documentos históricos carecen de metadatos XMP embebidos. |
Incorporación de metadatos XMP en las galeradas PDF, incluyendo Dublin Core, PRISM, CrossMark y PDFX. |
|
Interoperabilidad OAI-PMH |
Disponibilidad de servicios de metadatos mediante esquemas estándar, entre ellos oai_dc, y estructuras propias de la infraestructura de Elsevier. |
Esquema OAI-PMH extendido, con referencias bibliográficas completas, información de catalogación, imágenes, disciplinas y financiación. |
La comparación también permite observar que la disponibilidad de metadatos en una página web y su incorporación al documento PDF son dimensiones diferentes, aunque complementarias. La primera facilita el procesamiento de la publicación desde su entorno web; la segunda permite que parte de esa identidad documental acompañe al archivo cuando circula de manera independiente.
Invitamos a investigadores, editores y especialistas en información científica a realizar sus propias comprobaciones. Basta con ingresar a cualquiera de los artículos publicados en nuestra revista, seleccionar la opción «Ver código fuente de la página» y examinar la estructura que se encuentra disponible sin necesidad de ejecutar scripts. También es posible descargar los documentos PDF y consultar los metadatos incorporados mediante herramientas de inspección.
La infraestructura tecnológica debe poder examinarse, no solamente describirse. Por eso, preferimos que las características de MOJP 4.0 puedan ser comprobadas directamente por quienes trabajan con publicaciones científicas y sistemas de información académica.
Soberanía tecnológica y desarrollo editorial independiente
La puesta en producción de MOJP 4.0 expresa una decisión institucional que atraviesa toda la historia de la Fundación MenteClara: desarrollar capacidades propias para sostener una publicación científica independiente, sin renunciar a los principios del acceso abierto ni trasladar a los autores los costos de esa infraestructura.
El código abierto, sustentado en las libertades del software libre y en licencias como la GNU GPL, constituye una base fundamental para este propósito, pero no alcanza por sí solo para responder a todas las necesidades de una revista. La posibilidad de estudiar, modificar y ampliar el software permite que cada institución pueda construir soluciones adaptadas a sus objetivos, sus recursos y sus criterios editoriales.
En ese sentido, MOJP 4.0 representa tanto una plataforma de gestión como una experiencia de desarrollo tecnológico. Su arquitectura procura combinar rendimiento, interoperabilidad, privacidad, calidad de metadatos y facilidad de uso, demostrando que una publicación independiente puede abordar problemas técnicos complejos mediante ingeniería propia y sobre una base de software libre.
Agradecemos a nuestra comunidad académica, a los autores, revisores y lectores que acompañan este recorrido, y a todas las personas que contribuyen a sostener una publicación científica independiente. La evolución de nuestra infraestructura no responde a una búsqueda de sofisticación tecnológica por sí misma, sino a la convicción de que las herramientas deben mejorar las condiciones de producción, circulación y preservación del conocimiento.
Del entorno editorial al documento científico: una nueva etapa
La evolución de una plataforma editorial, sin embargo, no termina en la página web de la revista ni en los sistemas que permiten intercambiar sus registros bibliográficos.
Un artículo científico puede ser descargado, almacenado y compartido fuera del entorno en el que fue publicado. Puede incorporarse a un repositorio institucional, circular entre investigadores, conservarse en una biblioteca digital o reproducirse en otros espacios. En esos recorridos, el documento puede separarse de la página de la revista y perder parte del contexto que permite reconocer su procedencia, sus condiciones de publicación y su identidad editorial.
Por eso, consideramos que la información científica no debería depender exclusivamente del sistema desde el cual se accede al artículo. Una infraestructura editorial completa debe prestar atención también a los formatos documentales que circulan de manera independiente.
Esta preocupación no es nueva para la Fundación MenteClara. Desde 2016, nuestros documentos científicos en formato PDF incorporan metadatos extendidos mediante plantillas XMP elaboradas y aplicadas manualmente. Esta práctica, sostenida a lo largo de los años, nos permitió acumular experiencia sobre las posibilidades de enriquecer los documentos y preservar en ellos información bibliográfica, editorial y de derechos.
La incorporación manual de esos metadatos, sin embargo, demandaba un tiempo de trabajo especializado que dificultaba su aplicación sistemática en cada nueva publicación. La experiencia acumulada abrió así una nueva etapa de desarrollo: transformar un procedimiento editorial que realizábamos manualmente en una tecnología capaz de automatizarlo, integrarlo al flujo de producción y hacerlo accesible a otras publicaciones científicas.
La evolución de la infraestructura editorial no termina en la plataforma: también alcanza al documento científico y a la información que este conserva.
Como parte de esta evolución, incorporamos a MOJP 4.0 el Módulo XMP-PDF, una tecnología integrada en la plataforma y compatible con OJS 3.5.0.5 o superior:
Módulo XMP-PDF
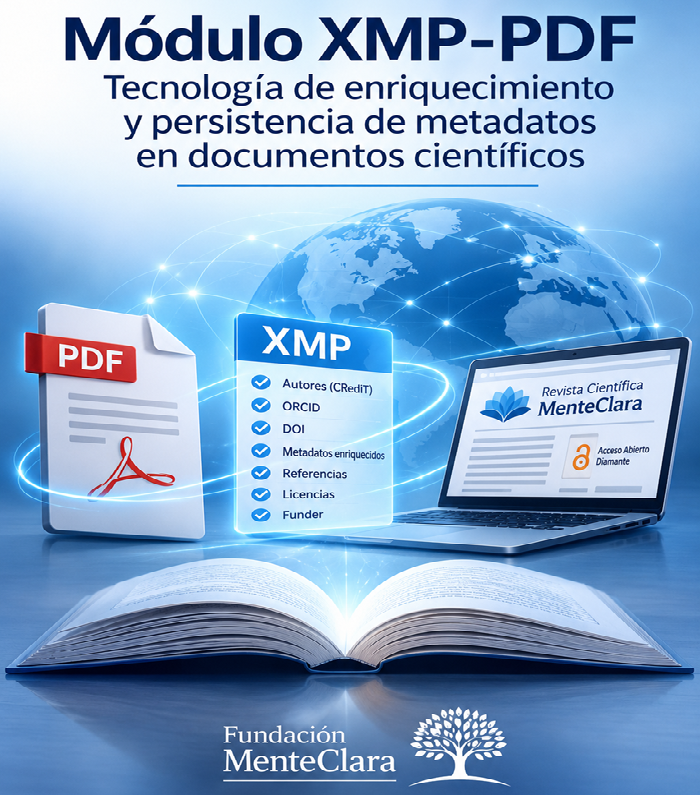
Tecnología de enriquecimiento y persistencia de metadatos en documentos científicos
La identidad editorial de una publicación científica viaja con su documento
Que el artículo viaje. Que su identidad permanezca. Que su procedencia pueda reconocerse.
Un artículo científico no termina su recorrido cuando se publica en una revista. Sus archivos PDF se descargan, comparten, almacenan, incorporan a repositorios, circulan por redes académicas y se distribuyen fuera de la plataforma editorial que los originó.
Sin embargo, cuando el documento se separa de su sitio de publicación, parte de la información que permite identificarlo, contextualizarlo y reconocer su procedencia puede quedar fuera de él.
Módulo XMP-PDF permite incorporar metadatos bibliográficos, editoriales y documentales directamente en los archivos PDF, para que esa información acompañe al artículo durante su circulación.
Desarrollado a partir de una experiencia editorial iniciada en 2016 y probado satisfactoriamente en instancias de producción reales, automatiza en menos de un minuto una tarea que, realizada manualmente, puede demandar al menos una hora por documento.
No se trata solamente de agregar información a un archivo. Se trata de preservar la identidad documental y editorial de las publicaciones científicas.
El problema: cuando el documento se separa de su contexto editorial
Las revistas científicas disponen de sistemas de gestión editorial que almacenan y presentan información sobre cada artículo: título, autores, afiliaciones, identificadores persistentes, resumen, palabras clave, fecha de publicación, revista, volumen, número, derechos y otros datos.
Las infraestructuras de información académica, como Crossref, permiten registrar y distribuir una parte de esos metadatos. Los repositorios, catálogos y servicios de indización también los recopilan y procesan.
Pero existe una diferencia fundamental entre los metadatos asociados a un registro editorial y los metadatos incorporados directamente en el documento que circula.
Cuando un PDF se descarga y se comparte fuera de la plataforma de origen, puede perder el contexto que permite reconocer de dónde procede, a qué publicación pertenece y bajo qué condiciones puede utilizarse.
El archivo continúa existiendo, pero su relación con la revista, su identificación bibliográfica y parte de su información editorial pueden dejar de estar disponibles para quien lo recibe.
La identidad editorial de un artículo no debería depender exclusivamente del sitio web desde el cual se descarga.
El documento científico también puede transportar información estructurada sobre sí mismo.
¿Qué es Módulo XMP-PDF?
Módulo XMP-PDF es una tecnología de enriquecimiento documental que incorpora metadatos estructurados directamente en archivos PDF de publicaciones científicas.
Utiliza XMP (Extensible Metadata Platform), un modelo de metadatos desarrollado para integrar información descriptiva y administrativa en archivos digitales.
La tecnología permite generar la información XML correspondiente e incorporarla al PDF, sin modificar el contenido editorial visible de la galerada.
La información se obtiene de los registros disponibles en la base de datos de la propia revista y de los parámetros específicos de configuración editorial.
De este modo, el documento puede conservar información bibliográfica, identificación de autores, procedencia editorial, derechos y otros elementos relevantes incluso cuando circula independientemente de la plataforma de publicación.
Módulo XMP-PDF se implementa como un módulo integrado en entornos MOJP 4.0 y es compatible con OJS 3.5.0.5 o superior. Su instalación y configuración se adaptan a las características y políticas de cada publicación.
Una experiencia editorial iniciada en 2016
El desarrollo de Módulo XMP-PDF tiene un antecedente concreto: desde 2016, la Fundación MenteClara incorpora metadatos extendidos en sus documentos PDF mediante plantillas XMP preparadas y aplicadas manualmente.
Durante años, esta práctica permitió enriquecer los archivos publicados con información que no se limitaba a los metadatos básicos del documento.
La experiencia también permitió reconocer sus dificultades: preparar los datos, generar la plantilla, comprobar su correspondencia con el artículo y realizar la incorporación al PDF exigían tiempo y conocimientos técnicos.
La automatización de ese procedimiento fue un objetivo de desarrollo tecnológico sostenido durante meses.
El resultado es una herramienta que transforma una tarea especializada, lenta y difícil de mantener a escala, en una operación integrada al flujo editorial.
No se trata de una funcionalidad concebida únicamente desde una perspectiva informática. Es la automatización de una práctica editorial experimentada y sostenida durante más de diez años.
De una hora de trabajo a menos de un minuto
La incorporación manual de metadatos extendidos requiere un tratamiento individual de cada documento. En la experiencia de trabajo de la Fundación MenteClara, esta operación puede demandar al menos una hora.
Para una revista con pocos artículos, el procedimiento puede resultar asumible. Pero cuando aumenta el flujo editorial, el tiempo necesario se convierte en una barrera.
Las revistas pequeñas, las publicaciones universitarias y los proyectos editoriales con recursos limitados difícilmente pueden destinar una hora de trabajo especializado a cada PDF publicado.
La consecuencia es previsible: una tarea valiosa termina postergándose, realizándose de manera irregular o abandonándose.
Módulo XMP-PDF automatiza el procedimiento y permite completar la incorporación de metadatos en menos de un minuto por documento, en las condiciones de operación previstas para el módulo.
|
Procedimiento |
Tiempo aproximado |
|
Incorporación manual |
Al menos 60 minutos |
|
Con Módulo XMP-PDF |
Menos de 1 minuto |
Esto representa una reducción superior al 98 % del tiempo operativo, tomando como referencia una hora de trabajo manual.
La diferencia no es solamente de velocidad. La automatización hace posible sostener una práctica de enriquecimiento documental que, por sus exigencias operativas, puede resultar inaccesible para muchas publicaciones científicas.
¿Qué información puede incorporar?
La información que se incorpora depende de los datos disponibles en la revista, de las características del artículo y de la configuración particular de cada instalación.
Entre los elementos que pueden integrarse se encuentran:
- Identificación bibliográfica: título del artículo, autores, revista, ISSN, volumen, número, páginas o identificador de artículo y fecha de publicación.
- Identificadores persistentes: DOI del artículo y ORCID de los autores, cuando estén disponibles.
- Descripción documental: resumen, palabras clave, idioma y otros elementos descriptivos.
- Procedencia editorial: nombre de la publicación y datos que permiten identificar el entorno editorial de origen.
- Información sobre el proceso editorial: datos y declaraciones relativos a las políticas de evaluación y publicación de la revista, cuando corresponda.
- Actualización y estado del documento: información CrossMark, cuando la revista dispone de la configuración e identificador correspondientes.
- Derechos y licencias: declaraciones de copyright, condiciones de reproducción, distribución y reutilización, de acuerdo con la política de cada publicación.
La información no se incorpora de manera indiscriminada. Se utilizan los datos disponibles y aplicables a cada documento, respetando las particularidades de la revista.
Un documento enriquecido, no una política editorial uniforme
Cada publicación científica tiene sus propias políticas de derechos, licencias, evaluación y distribución.
Una revista puede utilizar una licencia Creative Commons que permita la reutilización comercial con atribución. Otra puede establecer restricciones de reproducción o distribución. También existen diferencias en la titularidad del copyright y en los derechos que conservan los autores.
Módulo XMP-PDF no impone una licencia, un régimen de acceso ni un modelo editorial determinado.
La información se configura de acuerdo con las condiciones declaradas por cada revista.
Lo mismo sucede con la información relativa a la evaluación por pares. El módulo puede incorporar datos y declaraciones editoriales pertinentes, pero no certifica por sí mismo que un procedimiento se haya cumplido ni sustituye los registros que documentan ese proceso.
CrossMark, por su parte, permite comunicar información sobre actualizaciones y estado del documento. No constituye por sí mismo una certificación de revisión por pares.
La tecnología transporta la información editorial de cada publicación; no reemplaza sus políticas ni las convierte en un modelo único.
Metadatos académicos abiertos: una necesidad que trasciende los registros bibliográficos
La discusión internacional sobre metadatos académicos ha evolucionado. Ya no se limita a mejorar la identificación de las publicaciones o su descubrimiento en buscadores. También comprende la transparencia, la reutilización, la interoperabilidad, la procedencia y la preservación de la información científica.
La Declaración de Barcelona sobre la Información de Investigación Abierta constituye uno de los marcos internacionales que impulsan esta transformación.
En noviembre de 2026, un grupo de trabajo vinculado a la Declaración publicó el informe Open Scholarly Metadata Across Publication Formats: A Literature Review (Barcelona, 2026). El documento examina qué elementos de metadatos son considerados esenciales o deseables en distintos formatos de publicación y cuáles son las barreras que enfrentan las editoriales con recursos limitados para producirlos y distribuirlos.
Entre los elementos identificados con mayor frecuencia se encuentran:
- Información bibliográfica.
- Nombres, afiliaciones y roles de los colaboradores.
- Fechas y tipos de publicación.
- Identificadores persistentes.
- Información sobre derechos y licencias.
- Clasificaciones temáticas.
El informe también identifica como elementos deseables, entre otros, las referencias bibliográficas, los metadatos CrossMark y la documentación de la revisión por pares.
Especialmente relevante para las publicaciones pequeñas es el análisis de las barreras: limitaciones financieras, falta de infraestructura, conocimientos técnicos insuficientes, escasez de tiempo, incompatibilidades entre sistemas y dificultades para crear, procesar y distribuir metadatos de calidad.
El documento señala, además, que los metadatos pueden perder información o degradarse durante su circulación entre sistemas editoriales, agencias de registro, agregadores, índices y catálogos bibliotecarios.
También destaca que las plataformas de publicación de revistas, entre ellas OJS, pueden contribuir a mejorar estos procesos, aunque las editoriales necesitan apoyo técnico y recursos para incorporar las mejoras a su trabajo cotidiano.
El informe no prescribe una tecnología única ni establece que todos los metadatos deban incorporarse a los archivos PDF. Su aporte es identificar problemas y necesidades compartidas por el ecosistema de comunicación científica, así como la importancia de desarrollar prácticas abiertas, interoperables y adaptadas a la diversidad de los resultados de investigación.
En ese contexto, Módulo XMP-PDF propone una respuesta tecnológica complementaria: extender la disponibilidad de los metadatos desde los sistemas que administran las publicaciones hasta los propios documentos que circulan.
Esta perspectiva coincide con los principios promovidos por la Declaración de Barcelona sobre la Información de Investigación Abierta y con las necesidades identificadas en el informe citado, particularmente en lo relativo a la disponibilidad, interoperabilidad y reutilización de los metadatos en distintos formatos de publicación. La propuesta parte de una premisa sencilla:
Si los metadatos permiten identificar, describir, relacionar y reutilizar la producción científica, su disponibilidad no debería limitarse al registro alojado en una plataforma. También pueden acompañar al objeto documental que describen.
Del registro editorial al documento: dos capas complementarias
Los registros de DOI y los metadatos incorporados en un PDF cumplen funciones relacionadas, pero diferentes.
Los registros depositados en agencias como Crossref permiten identificar publicaciones y establecer relaciones entre artículos, autores, revistas, referencias y otros elementos del ecosistema académico.
Los metadatos XMP, en cambio, acompañan al archivo PDF y permanecen incorporados en él cuando el documento se descarga y circula fuera de la plataforma editorial.
No se trata de sustituir los registros DOI ni de duplicar innecesariamente las infraestructuras existentes.
Se trata de complementar ambas capas de información.
La base de datos editorial constituye la fuente de los datos utilizados por el módulo. La información disponible en la revista alimenta tanto los procesos de exportación de metadatos como la incorporación de información al PDF.
De este modo, el documento enriquecido conserva una representación estructurada de su identidad bibliográfica y editorial, sin depender exclusivamente de la consulta posterior de un sitio externo.
¿Qué diferencia existe entre un PDF convencional y uno enriquecido?
|
PDF convencional |
PDF enriquecido con XMP |
|
Puede contener información descriptiva básica. |
Incorpora metadatos estructurados adicionales. |
|
Su identificación puede depender de información externa. |
Transporta información bibliográfica y editorial dentro del archivo. |
|
Puede circular separado del contexto de publicación. |
Conserva datos que permiten reconocer su procedencia. |
|
La información sobre derechos puede estar limitada a una declaración visible. |
Puede incorporar información estructurada sobre derechos y licencias. |
|
La información adicional puede requerir consultas a otros sistemas. |
Parte de esa información acompaña directamente al documento. |
La incorporación de XMP no garantiza por sí sola la indización en un servicio determinado ni reemplaza los mecanismos de registro, preservación o descubrimiento. Su aporte consiste en ofrecer información estructurada, incorporada al propio archivo y disponible para herramientas compatibles.
Tecnología desarrollada para el trabajo editorial real
Módulo XMP-PDF nace de la experiencia de una revista científica arbitrada y de la necesidad de resolver un procedimiento que, durante años, fue realizado manualmente.
Su desarrollo contempla la generación de información XML y su incorporación efectiva al PDF mediante tecnología propia, integrada al entorno editorial.
El objetivo es ofrecer una solución que pueda utilizarse en el trabajo cotidiano de una revista, sin exigir que sus responsables reproduzcan manualmente procedimientos técnicos complejos.
El módulo ha sido probado satisfactoriamente en instancias de producción reales.
Su instalación comprende la adaptación a la configuración de la revista, la definición de los parámetros editoriales correspondientes y la puesta en funcionamiento de la herramienta.
No es una solución genérica que imponga los mismos datos a todas las publicaciones. Cada instalación debe contemplar las características y necesidades de su entorno editorial.
¿A quién está dirigido?
Módulo XMP-PDF está pensado para organizaciones que producen, gestionan, preservan o distribuyen documentos científicos y académicos.
Entre sus destinatarios se encuentran:
- Revistas científicas universitarias e independientes.
- Publicaciones de acceso abierto, suscripción y modelos financiados mediante APC.
- Editoriales académicas y universitarias.
- Bibliotecas y repositorios institucionales.
- Instituciones de investigación y organismos científicos.
- Equipos responsables de plataformas de publicación académica.
Su utilidad no depende de que una publicación adopte un modelo de acceso abierto determinado. La incorporación de metadatos estructurados puede contribuir a la identificación y contextualización documental en diferentes modelos editoriales.
Implementación y acompañamiento
Módulo XMP-PDF se ofrece como una tecnología integrada al entorno editorial OJS/MOJP, con instalación y configuración adaptadas a cada publicación.
La puesta en marcha contempla:
- Instalación del módulo.
- Configuración de los metadatos y parámetros editoriales.
- Adaptación de las declaraciones de derechos y licencias.
- Configuración de los identificadores y datos específicos que correspondan.
- Verificación de funcionamiento.
- Acompañamiento técnico y soporte.
El propósito es que la revista pueda incorporar la tecnología a su flujo habitual de publicación, sin tener que desarrollar por cuenta propia los procedimientos de generación e inyección de metadatos.
Una tecnología nacida de una necesidad editorial
Desde 2016, la Fundación MenteClara sostuvo manualmente la incorporación de metadatos extendidos en sus documentos PDF.
Esa experiencia permitió comprobar el valor de preservar información editorial dentro de los propios documentos, pero también mostró los límites de un procedimiento que demanda tiempo y conocimientos especializados.
El crecimiento de la producción científica y la necesidad de mejorar la calidad, disponibilidad e interoperabilidad de los metadatos hacen cada vez menos viable depender exclusivamente de tareas manuales.
Módulo XMP-PDF transforma esa experiencia en una solución tecnológica que puede extenderse a otras publicaciones.
Su propósito es que las revistas, independientemente de su tamaño y capacidad operativa, puedan incorporar información estructurada a sus documentos sin que esa tarea se convierta en una carga adicional difícil de sostener.
La identidad de un artículo científico no debería perderse cuando el archivo abandona la plataforma que lo publicó.
Que el artículo viaje. Que su identidad permanezca. Que su procedencia pueda reconocerse.
Tecnología de enriquecimiento y persistencia de metadatos en documentos científicos.
Bibliografía
Barcelona
Declaration on Open Research Information, Mitchell, D., Kunze, J., Waltman, L.,
& Steiner, T. (2026). Open Scholarly Metadata Across Publication Formats - A
Literature Review (Version 1.0). Zenodo.
https://doi.org/10.5281/zenodo.24084581
Doubrov, B., & von Seggern, D. (2021). PDF 2.0 application note 003: Use of
object metadata streams. PDF Association.
https://pdfa.org/resource/pdf-2-0-application-note-003-use-of-object-metadata-streams/
Hendricks, G., Tkaczyk, D., Lin, J., & Feeney, P. (2020). Crossref: The
sustainable source of community-owned scholarly metadata. Quantitative Science
Studies, 1(1), 414–427.
https://doi.org/10.1162/qss_a_00022
International Organization for Standardization. (2019). Graphic
technology—Extensible metadata platform (XMP)—Part 1: Data model, serialization
and core properties (ISO Standard No. 16684-1:2019).
https://www.iso.org/standard/75163.html
Rusch-Feja, D. (2002). The Open Archives Initiative and the OAI Protocol for
Metadata Harvesting: Rapidly forming a new tier in the scholarly communication
infrastructure. Learned Publishing, 15(3), 179–186.
https://doi.org/10.1087/095315102320140464
Subirats Coll, I., & Barrueco Cruz, J. M. (2003). Open Archives Initiative.
Protocol for Metadata Harvesting (OAI-PMH): Descripción, funciones y
aplicaciones de un protocolo. El Profesional de la Información, 12(2), 99–106.
https://doi.org/10.1076/epri.12.2.99.15473
Weagley, J., Gelches, E., & Park, J.-R. (2010). Interoperability and metadata
quality in digital video repositories: A study of Dublin Core. Journal of
Library Metadata, 10(1), 37–57.
https://doi.org/10.1080/19386380903546984
Rocío Silveira de Andrade
Editora
Dear Readers,
We close the year with a new stage of technological innovation for our journal. Our engineering team has developed and incorporated state-of-the-art improvements that strengthen the editorial infrastructure, expand interoperability capabilities, and contribute to more efficient dissemination of scientific output.
We are pleased to share these advances with you. They are the result of our sustained commitment to quality, innovation, and the independent development of technology for scientific communication.
Scientific communication does not depend exclusively on the quality of the content it publishes. It also requires a technological infrastructure capable of ensuring that information is available, can be properly identified and processed, and retains its integrity over time.
The editorial platform, metadata exchange systems, and scientific documents themselves are all part of this infrastructure and shape the possibilities for knowledge dissemination.
Since its inception, the Peer-Reviewed Scientific Journal of the MenteClara Foundation has maintained that editorial independence must be accompanied by an equivalent capacity for technological development. Our experience with Open Journal Systems (OJS), an open-source platform developed by the Public Knowledge Project (PKP), has enabled us to build and sustain a diamond open-access scholarly publishing model, free of charges for both authors and readers.
However, our accumulated experience has also shown that the needs of a scholarly publication are not always adequately addressed by the standard configurations of available platforms.
The evolution of our infrastructure has therefore been an ongoing process of research, adaptation, and development. It has not been limited to adopting new software versions: it has involved reviewing components, modifying processes, developing our own solutions, and expanding the possibilities for managing and disseminating scientific information.
This year, we publicly introduced MOJP 4.0 (MenteClara Open Journal Platform), developed by Oscar R. Gómez together with his engineering team, based on OJS 3.5.0.5. Its deployment represents a technical and institutional milestone for the MenteClara Foundation and consolidates a line of work focused on information sovereignty, performance, interoperability, and open science.
MOJP 4.0: An Editorial Infrastructure Developed for Open Science
MOJP 4.0 is not simply an OJS update. It is a comprehensive evolution of its architecture, incorporating proprietary developments designed to overcome operational limitations and expand the capabilities of a scholarly publishing platform. Its conception is based on a fundamental premise: an academic publishing infrastructure must be designed to facilitate editorial work as well as the identification, retrieval, reading, and exchange of the content it produces.
One of the key developments was the rewriting of the metadata engine, with particular attention to efficiency and clean source code. The result is an architecture that presents the bibliographic and editorial information of each article directly, in a structured and accessible manner. The source code of web pages is no longer merely a secondary aspect of their presentation; it becomes an essential part of the scientific communication infrastructure.
This decision is linked to the concept of Zero-JS Dependency, meaning that essential information is available without requiring JavaScript execution.
Discovery and indexing systems such as Dialnet, OpenAlex, SciELO, Redalyc, REDIB, DOAJ, and Google Scholar, among other scientific information and discovery services, can access the essential data of an article without having to process large amounts of code, resolve external dependencies, or navigate cookie mechanisms to retrieve bibliographic information.
In MOJP 4.0, the essential data—authors, ORCID identifiers, DOI, affiliations, and links to PDF and HTML files—are available directly within the first few kilobytes of the source code. This arrangement reduces technical intermediaries and makes it easier for automated systems to recognize the structure of each publication from the moment it is accessed.
Coexistence of Semantic Schemas and Structured Metadata
Direct metadata availability is complemented by the simultaneous incorporation of different international descriptive schemas. MOJP 4.0 allows the information associated with each article to be presented through semantic structures compatible with different processing and retrieval systems.
These include:
- Highwire Press / Google Scholar tags: elements such as citation_author and citation_author_orcid, designed to expose bibliographic and authorship information.
- Dublin Core: a broad description that includes elements such as DC.Creator and DC.Identifier.DOI.
- Schema.org: JSON-LD structures of the ScholarlyArticle type, which describe articles using a semantic vocabulary widely recognized across the web.
- Open Graph and Twitter Cards: designed to improve the interpretation and presentation of content when shared on social networks and other digital environments.
The coexistence of these schemas allows the same publication to be interpreted from different technical perspectives without relying on a single descriptive model. The purpose is not to multiply tags without a reason, but to provide structured and consistent information to the different environments involved in the circulation of scientific knowledge.
Architectural Extensibility: Custom Head Injector
As part of this development strategy, we incorporated Custom Head Injector, a native MOJP 4.0 module that can also be reused in other compatible installations and expands the possibilities for customizing the platform's HTML header.
Its main features include:
- Custom HTML metadata injection: allows additional information to be incorporated into the header of platform pages.
- Compatibility with semantic schemas: supports JSON-LD, Schema.org, and Open Graph structures.
- Visual and institutional customization: allows the incorporation of CSS stylesheets, favicons, and institutional links.
- Integration of external services: facilitates the insertion of verification scripts and analytics tools.
- Centralized administration: all these settings are managed through the administrative dashboard, without having to edit each page manually.
- Free software and compatibility: released under the GNU General Public License v3 (GPLv3), it is compatible with OJS 3.5.0.5 and later versions.
This development expands the platform's adaptability and provides other compatible installations with a reusable tool for managing their own metadata integration, identification, and presentation requirements.
[View the source code and download Custom Head Injector on GitHub.]
This architecture is further enhanced by linking publications to persistent institutional identifiers. The association with the MenteClara Foundation domain, ROR record 03pssnk88, and Crossref Funder ID 100032896 contributes to more precise identification of institutional provenance and funding relationships associated with editorial activities.
Performance, Privacy, and the Absence of Unnecessary Commercial Dependencies
Another central aspect of this development is the reduction of external components that provide no direct value to scientific communication. MOJP 4.0 dispenses with commercial trackers, advertising scripts, and third-party elements that may increase page size, interfere with processing, or compromise readers' privacy.
This decision reflects both performance criteria and an institutional understanding of scholarly publishing. An academic journal does not need to turn its readers' browsing activity into a source of commercial data exploitation, nor does it need to incorporate dependencies that make access to its content more difficult.
Instead, the architecture aims to present information in a clean, direct, and efficient manner. The absence of unnecessary intermediaries helps reduce loading times and facilitates reading by both people and automated systems.
Technological independence also means having the ability to decide which components are incorporated, how data are processed, and what information is exposed. In this respect, in-house development makes it possible to adapt the platform to the publication's needs without being constrained by the design decisions of a standard configuration.
An Expanded OAI-PMH Schema: More Information for Interoperability
Interoperability is another fundamental pillar of MOJP 4.0. The OAI-PMH protocol allows repositories, digital libraries, aggregators, and other services to harvest information from scholarly publications. However, the usefulness of this communication depends to a large extent on the depth and quality of the metadata each institution makes available.
For this reason, we developed a customized OAI schema that expands the information exposed in the platform's responses. In addition to the usual bibliographic elements, it incorporates complete article references, library cataloging data, cover images, disciplines, funding agencies, and other metadata available in the editorial record.
The aim is to make the fullest possible use of the information a journal produces and retains throughout its editorial activities, preventing exchanges between systems from being reduced to minimal identification when additional data are available that can enrich document description and retrieval.
This extension can be verified directly through our journal's OAI-PMH service. The following record provides a concrete example of the information exposed by MOJP 4.0:
[View an OAI-PMH record from the MenteClara Foundation Journal.]
The expanded schema is not merely an internal improvement. It represents a way of contributing to the circulation of scientific information across different infrastructures, with richer descriptive content and greater opportunities for reuse.
Persistent Identity and Historical Cleanup of ORCID Records
Authorship traceability is another essential component of scientific infrastructure. ORCID identifiers make it possible to distinguish researchers and link their contributions over time. However, changes in authentication mechanisms and platform versions can produce inconsistencies in historical records.
In MOJP 4.0, a procedure was developed to review and retrospectively clean up ORCID records spanning more than a decade of publications. This made it possible to restore the authentication marking of older profiles that, due to limitations in the authorization mechanisms available in previous versions, had been identified as unverified.
This work preserved the visual authentication indicators of those historical records and maintained the continuity of authorship information throughout the journal. The task involves more than simply adding ORCID to new articles; it also addresses the consistency of data accumulated over years of editorial activity.
This work is part of an approach to traceability that should not be limited to recent content: a publication's historical archive must also retain a consistent institutional and bibliographic identity.
XMP Metadata Injection into PDF Galley Files
The metadata architecture of MOJP 4.0 is not limited to web pages or to the records the platform provides through its exchange services. It also extends to PDF documents, which are one of the main formats through which scholarly articles circulate.
When a galley is finalized, each PDF file receives structured metadata through XMP. The schemas and information sets used include Dublin Core, PRISM, CrossMark, and PDFX.
In this way, the document incorporates information that makes it possible to recognize its bibliographic and editorial identity even when it circulates outside the journal's website. The PDF no longer depends exclusively on the context of the platform from which it was downloaded and can retain structured information about the article and its provenance.
This feature can be verified by downloading a PDF from our journal and examining its metadata using tools such as Exif.tools. Inspection makes it possible to view the information incorporated directly into the file and confirm that document enrichment is not limited to the data visible on the publication page.
The incorporation of XMP is part of a line of work that the MenteClara Foundation has maintained for years and that, with MOJP 4.0, has reached a new stage of integration with the editorial infrastructure.
A Platform Also Designed for Those Who Manage Journals
Technological development would have little purpose if its improvements were restricted to programming or server administration specialists. An editorial platform must enable the teams responsible for publications to manage their processes without having to constantly deal with complex configurations or technical barriers that divert their attention from academic work.
With MOJP 4.0, we also addressed the rigidities and operational difficulties found in standard OJS versions. The aim was to build a more user-friendly management environment that allows editorial processes to be completed from beginning to end without requiring prior technical knowledge or extensive training to use its everyday functions.
This approach is particularly important for independent journals, small and medium-sized academic institutions, and publishing projects that sustain diamond open-access models. A lack of technical resources should not become a structural disadvantage that prevents publications from providing high-quality infrastructure.
MOJP 4.0 seeks to demonstrate that in-house technological development can help bridge this gap. Combining an open-source foundation with specific adaptations makes it possible to build advanced solutions without passing on the costs of large commercial infrastructures to authors or readers.
Website or Scientific Visibility Engine?
A scholarly publication should not be evaluated solely on the appearance of its website. Visual design is important for reading and the browsing experience, but academic dissemination also depends on how search engines, indexing services, and exchange systems recognize and interpret the information associated with each article.
For this reason, a substantial part of the work carried out on MOJP 4.0 focused on the technical structure behind the visible page. Metadata quality, its location, consistency across schemas, and data availability for automated systems are all aspects that can influence how a publication is processed within the digital scientific ecosystem.
In our tests and comparative analyses, MOJP 4.0's metadata architecture has reached a level of development that can be compared with that of major international publishing platforms, such as Springer Nature and The Lancet. The comparison is not limited to the number of tags; it also considers data availability, the coexistence of schemas, institutional identification, and the information incorporated into documents.
The technical analysis conducted against The Lancet highlights several aspects:
Technical Comparison: MOJP 4.0 and The Lancet (Elsevier)
|
Aspect evaluated |
The Lancet (Elsevier) |
MOJP 4.0 |
|
Loading and indexing (Zero-JS) |
Architecture based on JavaScript frameworks, cookies, and external scripts. Automated information extraction may require code execution and dependency processing. |
Zero-JS Dependency architecture. Essential metadata are available directly within the first few kilobytes of the source code, without requiring JavaScript execution or cookie resolution. |
|
Integration of identifiers (ORCID, ROR, and Funder ID) |
ORCID integration in active author records. Coverage and validation of historical records may vary. |
Integration of ORCID, ROR, and Crossref Funder ID, with retrospective cleanup of historical authorship records and preservation of the visual authentication indicators of authenticated ORCID records. |
|
Coexistence of semantic schemas |
Use of Highwire Press, Dublin Core, and Schema.org. |
Coexistence of Highwire Press, full Dublin Core, Schema.org through JSON-LD, and Open Graph / Twitter Cards. |
|
XMP metadata in PDF galley files |
Metadata incorporation in PDF files varies according to the publication and production period; many historical documents lack embedded XMP metadata. |
XMP metadata incorporated into PDF galley files, including Dublin Core, PRISM, CrossMark, and PDFX. |
|
OAI-PMH interoperability |
Availability of metadata services through standard schemas, including oai_dc, and structures specific to Elsevier's infrastructure. |
Extended OAI-PMH schema, with complete bibliographic references, cataloging information, images, disciplines, and funding data. |
The comparison also shows that metadata availability on a web page and its incorporation into a PDF document are two different, although complementary, dimensions. The former facilitates the processing of a publication through its web environment; the latter allows part of its documentary identity to accompany the file when it circulates independently.
We invite researchers, editors, and specialists in scientific information to carry out their own checks. Simply access any article published in our journal, select the "View Page Source" option, and examine the structure available without executing scripts. It is also possible to download PDF documents and inspect their embedded metadata using appropriate tools.
Technological infrastructure must be open to examination, not merely described. For this reason, we prefer the features of MOJP 4.0 to be directly verifiable by those who work with scholarly publications and academic information systems.
Technological Sovereignty and Independent Editorial Development
The deployment of MOJP 4.0 expresses an institutional decision that runs throughout the history of the MenteClara Foundation: to develop in-house capabilities to sustain an independent scholarly publication, without abandoning the principles of open access or transferring the costs of that infrastructure to authors.
Open-source software, grounded in the freedoms of free software and licenses such as the GNU GPL, provides an essential foundation for this purpose, but it is not sufficient on its own to meet all the needs of a journal. The ability to study, modify, and extend software allows each institution to build solutions tailored to its objectives, resources, and editorial criteria.
In this respect, MOJP 4.0 represents both a management platform and an experience in technological development. Its architecture seeks to combine performance, interoperability, privacy, metadata quality, and ease of use, demonstrating that an independent publication can address complex technical challenges through in-house engineering built on a free software foundation.
We thank our academic community, authors, reviewers, and readers who accompany us on this journey, as well as everyone who contributes to sustaining an independent scholarly publication. The evolution of our infrastructure is not driven by the pursuit of technological sophistication for its own sake, but by the conviction that tools should improve the conditions under which knowledge is produced, circulated, and preserved.
From the Editorial Environment to the Scientific Document: A New Stage
The evolution of an editorial platform, however, does not end with the journal's website or the systems that make it possible to exchange bibliographic records.
A scholarly article can be downloaded, stored, and shared outside the environment in which it was published. It can be deposited in an institutional repository, circulated among researchers, preserved in a digital library, or reproduced in other settings. Along these paths, the document may become separated from the journal's website and lose part of the context that makes it possible to identify its provenance, publication conditions, and editorial identity.
For this reason, we believe that scientific information should not depend exclusively on the system through which an article is accessed. A complete editorial infrastructure must also pay attention to the document formats that circulate independently.
This concern is not new to the MenteClara Foundation. Since 2016, our scientific documents in PDF format have incorporated extended metadata through XMP templates prepared and applied manually. This practice, sustained over the years, has allowed us to accumulate experience regarding the possibilities of enriching documents and preserving bibliographic, editorial, and rights information within them.
The manual incorporation of this metadata, however, required specialized work time, making it difficult to apply systematically to every new publication. Our accumulated experience thus opened a new stage of development: transforming an editorial procedure we had been carrying out manually into a technology capable of automating it, integrating it into the production workflow, and making it accessible to other scholarly publications.
The evolution of editorial infrastructure does not end with the platform: it also extends to the scientific document and the information it retains.
As part of this evolution, we incorporated the XMP-PDF Module into MOJP 4.0, a technology integrated into the platform and compatible with OJS 3.5.0.5 or later:
XMP-PDF Module
Technology for Enriching and Preserving Metadata in Scientific Documents
The Editorial Identity of a Scholarly Publication Travels with Its Document
Let the article travel. Let its identity remain. Let its provenance be recognizable.
A scholarly article does not complete its journey when it is published in a journal. Its PDF files are downloaded, shared, stored, deposited in repositories, circulated through academic networks, and distributed outside the editorial platform that originally published them.
However, when a document becomes separated from its publication website, some of the information that makes it possible to identify it, provide context, and recognize its provenance may be left behind.
The XMP-PDF Module makes it possible to incorporate bibliographic, editorial, and documentary metadata directly into PDF files, so that this information accompanies the article throughout its circulation.
Developed from an editorial experience that began in 2016 and successfully tested in real production environments, it automates in less than one minute a task that, when performed manually, may require at least one hour per document.
This is not simply a matter of adding information to a file. It is about preserving the documentary and editorial identity of scholarly publications.
The Problem: When a Document Becomes Separated from Its Editorial Context
Scholarly journals have editorial management systems that store and present information about each article: title, authors, affiliations, persistent identifiers, abstract, keywords, publication date, journal, volume, issue, rights, and other data.
Academic information infrastructures such as Crossref make it possible to register and distribute some of this metadata. Repositories, catalogs, and indexing services also collect and process it.
However, there is a fundamental difference between metadata associated with an editorial record and metadata incorporated directly into the document that circulates.
When a PDF is downloaded and shared outside its original platform, it may lose the context that makes it possible to identify where it came from, which publication it belongs to, and under what conditions it may be used.
The file continues to exist, but its relationship with the journal, its bibliographic identification, and part of its editorial information may no longer be available to whoever receives it.
An article's editorial identity should not depend exclusively on the website from which it is downloaded.
The scientific document itself can also carry structured information about its own identity.
What Is the XMP-PDF Module?
The XMP-PDF Module is a document-enrichment technology that incorporates structured metadata directly into PDF files of scholarly publications.
It uses XMP (Extensible Metadata Platform), a metadata model developed to integrate descriptive and administrative information into digital files.
The technology makes it possible to generate the corresponding XML information and embed it in the PDF without modifying the visible editorial content of the galley.
The information is obtained from the records available in the journal's own database and from the specific editorial configuration parameters.
In this way, the document can retain bibliographic information, author identification, editorial provenance, rights, and other relevant elements even when it circulates independently of the publishing platform.
The XMP-PDF Module is implemented as an integrated module in MOJP 4.0 environments and is compatible with OJS 3.5.0.5 or later. Its installation and configuration are adapted to the characteristics and policies of each publication.
An Editorial Experience That Began in 2016
The XMP-PDF Module has a concrete precedent: since 2016, the MenteClara Foundation has incorporated extended metadata into its PDF documents through XMP templates prepared and applied manually.
For years, this practice allowed us to enrich published files with information extending beyond the document's basic metadata.
The experience also revealed the difficulties involved: preparing the data, generating the template, checking that it corresponded to the article, and embedding it in the PDF required time and technical expertise.
Automating this procedure became a sustained technological development objective over several months.
The result is a tool that transforms a specialized task, slow and difficult to maintain at scale, into an operation integrated into the editorial workflow.
This is not a feature conceived solely from an IT perspective. It is the automation of an editorial practice tested and sustained for more than ten years.
From One Hour of Work to Less Than One Minute
The manual incorporation of extended metadata requires each document to be processed individually. Based on the MenteClara Foundation's working experience, this operation may take at least one hour.
For a journal publishing only a few articles, the procedure may be manageable. However, as the editorial workload increases, the time required becomes a barrier.
Small journals, university publications, and editorial projects with limited resources may find it difficult to allocate one hour of specialized work to every PDF they publish.
The consequence is predictable: a valuable task ends up being postponed, performed inconsistently, or abandoned.
The XMP-PDF Module automates the procedure and makes it possible to complete metadata incorporation in less than one minute per document, under the operating conditions for which the module is designed.
|
Procedure |
Approximate time |
|
Manual incorporation |
At least 60 minutes |
|
With the XMP-PDF Module |
Less than 1 minute |
This represents an operational time reduction of more than 98%, using one hour of manual work as the baseline.
The difference is not merely a matter of speed. Automation makes it possible to sustain a document-enrichment practice that, because of its operational demands, may otherwise be inaccessible to many scholarly publications.
What Information Can It Incorporate?
The information incorporated depends on the data available in the journal, the characteristics of the article, and the specific configuration of each installation.
The elements that can be integrated include:
- Bibliographic identification: article title, authors, journal, ISSN, volume, issue, pages or article identifier, and publication date.
- Persistent identifiers: article DOI and authors' ORCID identifiers, when available.
- Document description: abstract, keywords, language, and other descriptive elements.
- Editorial provenance: publication name and data that identify the original editorial environment.
- Information about the editorial process: data and statements concerning the journal's peer-review and publication policies, where applicable.
- Document updates and status: CrossMark information, when the journal has the corresponding configuration and identifier.
- Rights and licenses: copyright statements and conditions for reproduction, distribution, and reuse, in accordance with each publication's policy.
Information is not incorporated indiscriminately. Only data available and applicable to each document are used, respecting the particular characteristics of each journal.
An Enriched Document, Not a Uniform Editorial Policy
Every scholarly publication has its own policies concerning rights, licenses, peer review, and distribution.
A journal may use a Creative Commons license that allows commercial reuse with attribution. Another may impose restrictions on reproduction or distribution. There are also differences in copyright ownership and in the rights retained by authors.
The XMP-PDF Module does not impose a license, an access regime, or a particular publishing model.
The information is configured according to the conditions declared by each journal.
The same applies to information concerning peer review. The module can incorporate relevant editorial data and statements, but it does not independently certify that a procedure has been carried out, nor does it replace the records documenting that process.
CrossMark, in turn, makes it possible to communicate information about document updates and status. It does not, in itself, constitute certification of peer review.
The technology carries each publication's editorial information; it does not replace its policies or turn them into a single standardized model.
Open Scholarly Metadata: A Need That Goes Beyond Bibliographic Records
The international discussion on scholarly metadata has evolved. It is no longer limited to improving publication identification or discoverability through search engines. It also encompasses transparency, reuse, interoperability, provenance, and the preservation of scientific information.
The Barcelona Declaration on Open Research Information is one of the international frameworks driving this transformation.
In November 2026, a working group associated with the Declaration published the report Open Scholarly Metadata Across Publication Formats: A Literature Review. The document examines which metadata elements are considered essential or desirable across different publication formats, as well as the barriers faced by publishers with limited resources when producing and distributing them.
The elements most frequently identified include:
- Bibliographic information.
- Names, affiliations, and roles of contributors.
- Publication dates and types.
- Persistent identifiers.
- Rights and licensing information.
- Subject classifications.
The report also identifies other desirable elements, including bibliographic references, CrossMark metadata, and peer-review documentation.
The analysis of barriers is particularly relevant to smaller publications: financial constraints, lack of infrastructure, insufficient technical expertise, limited time, incompatibilities between systems, and difficulties in creating, processing, and distributing high-quality metadata.
The document also points out that metadata may lose information or become degraded as it circulates between editorial systems, registration agencies, aggregators, indexes, and library catalogs.
It further highlights that journal publishing platforms, including OJS, can help improve these processes, although publishers need technical support and resources to incorporate such improvements into their everyday work.
The report does not prescribe a single technology, nor does it establish that all metadata should be incorporated into PDF files. Its contribution is to identify problems and needs shared across the scientific communication ecosystem, as well as the importance of developing open, interoperable practices adapted to the diversity of research outputs.
In this context, the XMP-PDF Module proposes a complementary technological response: extending metadata availability from the systems that manage publications to the documents themselves as they circulate.
This approach is consistent with the principles promoted by the Barcelona Declaration on Open Research Information and with the needs identified in the cited report, particularly regarding metadata availability, interoperability, and reuse across different publication formats. The proposal is based on a simple premise:
If metadata make it possible to identify, describe, relate, and reuse scientific output, their availability should not be limited to the record hosted on a platform. They can also accompany the documentary object they describe.
From the Editorial Record to the Document: Two Complementary Layers
DOI records and metadata embedded in a PDF serve related but different purposes.
Records deposited with agencies such as Crossref make it possible to identify publications and establish relationships between articles, authors, journals, references, and other elements of the academic ecosystem.
XMP metadata, by contrast, accompanies the PDF file and remains embedded in it when the document is downloaded and circulated outside the editorial platform.
The aim is not to replace DOI records or unnecessarily duplicate existing infrastructures.
It is to make both information layers complementary.
The editorial database is the source of the data used by the module. The information available in the journal feeds both metadata export processes and the incorporation of information into the PDF.
In this way, the enriched document retains a structured representation of its bibliographic and editorial identity without depending exclusively on a subsequent query to an external website.
What Is the Difference Between a Conventional PDF and an Enriched PDF?
|
Conventional PDF |
PDF enriched with XMP |
|
May contain basic descriptive information. |
Incorporates additional structured metadata. |
|
Its identification may depend on external information. |
Carries bibliographic and editorial information within the file. |
|
May circulate separately from its publication context. |
Retains data that make its provenance recognizable. |
|
Rights information may be limited to a visible statement. |
Can incorporate structured information about rights and licenses. |
|
Additional information may require queries to other systems. |
Some of that information accompanies the document directly. |
The incorporation of XMP does not, by itself, guarantee indexing by any particular service, nor does it replace registration, preservation, or discovery mechanisms. Its contribution is to provide structured information embedded in the file itself and available to compatible tools.
Technology Developed for Real Editorial Work
The XMP-PDF Module stems from the experience of a peer-reviewed scholarly journal and the need to solve a procedure that had been performed manually for years.
Its development includes generating XML information and effectively embedding it in the PDF through proprietary technology integrated into the editorial environment.
The aim is to provide a solution that can be used in a journal's everyday work without requiring those responsible for the publication to manually reproduce complex technical procedures.
The module has been successfully tested in real production environments.
Its installation includes adapting it to the journal's configuration, defining the corresponding editorial parameters, and putting the tool into operation.
It is not a generic solution that imposes the same data on every publication. Each installation must take into account the characteristics and needs of its own editorial environment.
Who Is It Intended For?
The XMP-PDF Module is designed for organizations that produce, manage, preserve, or distribute scientific and academic documents.
Its intended users include:
- University-based and independent scholarly journals.
- Open-access, subscription-based, and APC-funded publications.
- Academic and university presses.
- Libraries and institutional repositories.
- Research institutions and scientific organizations.
- Teams responsible for academic publishing platforms.
Its usefulness does not depend on a publication adopting any particular open-access model. The incorporation of structured metadata can contribute to document identification and contextualization across different publishing models.
Implementation and Support
The XMP-PDF Module is offered as a technology integrated into the OJS/MOJP editorial environment, with installation and configuration adapted to each publication.
Implementation includes:
- Module installation.
- Configuration of metadata and editorial parameters.
- Adaptation of rights and licensing statements.
- Configuration of the relevant identifiers and specific data.
- Operational verification.
- Technical guidance and support.
The aim is to enable the journal to incorporate the technology into its regular publishing workflow without having to develop its own metadata generation and injection procedures.
A Technology Born from an Editorial Need
Since 2016, the MenteClara Foundation has manually incorporated extended metadata into its PDF documents.
This experience made it possible to demonstrate the value of preserving editorial information within the documents themselves, but it also revealed the limitations of a procedure requiring time and specialized knowledge.
The growth of scientific output and the need to improve metadata quality, availability, and interoperability make it increasingly unfeasible to rely exclusively on manual tasks.
The XMP-PDF Module transforms that experience into a technological solution that can be extended to other publications.
Its purpose is to enable journals, regardless of their size or operational capacity, to incorporate structured information into their documents without turning that task into an additional burden that is difficult to sustain.
The identity of a scholarly article should not be lost when the file leaves the platform that published it.
Let the article travel. Let its identity remain. Let its provenance be recognizable.
Technology for enriching and preserving metadata in scientific documents.